Google baut, NVIDIA optimiert, wir optimieren noch mal: unser kleines KI-Modell
Vor einiger Zeit haben wir über unseren AI-Cluster und unseren Weg zur eigenen KI-Infrastruktur berichtet. Inzwischen ist daraus mehr geworden als ein Server, auf dem fertige Modelle laufen: Wir optimieren inzwischen selbst welche.
Die Kette sieht nämlich so aus: Google hat mit der Gemma-Architektur das zugrunde liegende Modell gebaut. NVIDIA hat daraus ein sehr schnelles, stark beschleunigtes Modell gemacht. Und wir haben es noch einmal für unsere Hardware und unsere Zwecke optimiert – von knapp 15 Gigabyte auf etwa 6 Gigabyte, und so gerechnet, dass unsere neuen Grafikkarten damit richtig schnell arbeiten können.
Wichtig dabei: Das ist kein Geheimnis und nichts Exklusives. Alles davon ist offen verfügbar, frei herunterladbar und von jedem nachbaubar. Dieser Artikel erzählt, wie das bei uns gelaufen ist, woran wir richtig geknobelt haben und was wir beim nächsten Mal anders machen.
Warum eigentlich?
Die Idee dahinter war von Anfang an sehr praktisch gedacht. Ein KI-Modell, das 15 Gigabyte belegt, ist für uns aus drei Gründen unbefriedigend:
Erstens läuft es dann nur noch auf Spezialhardware. Wir haben unseren DGX Spark, auf dem wir Modelle betreiben – aber wir haben auch eine RTX 5060 Ti im Haus, und die soll das Modell bitte auch schaffen.
Zweitens wollen unsere Teilnehmer:innen nicht für jede Kleinigkeit auf den Server müssen. Wer an einer eigenen Idee bastelt, wer einen Prototypen baut oder einfach nur in Ruhe debuggen will, soll das Ding auf dem eigenen Rechner starten können. Ohne VPN, ohne Wartezeit, ohne dass zehn Leute gleichzeitig auf eine Maschine zugreifen.
Und drittens – eigentlich der Hauptgrund – geht es um Tempo. Es reicht uns nicht, das Modell nur irgendsowohl auf dem Spark zum Laufen zu bringen; es soll dort auch richtig schnell sein. Und da kommt die Rechengenauigkeit ins Spiel: Moderne Blackwell-Chips können Zahlen in niedrigerer Genauigkeit deutlich schneller verarbeiten. 8-Bit-Rechnungen sind schneller als die 16-Bit-Rechnungen, in denen das Modell veröffentlicht ist – und 4-Bit-Rechnungen noch mal schneller als 8-Bit. Das gilt allerdings wirklich nur für die aktuellen Chips, denn nur die können solche 4-Bit-Rechnungen überhaupt direkt in Hardware. Genau diese Eigenschaft wollten wir ausnutzen, und deshalb war von Anfang an klar: Wir gehen bis auf 4 Bit runter.
Für den zweiten Punkt haben wir neben dem eigentlichen Modell auch eine GGUF-Version gebaut. Das ist ein Format, das mit sehr verbreiteten, einfachen Tools läuft und auf dem normalen Windows- oder Linux-PC ohne großen Aufwand startet. Wer also keinen NVIDIA-Server im Keller hat, kann trotzdem damit arbeiten – ein bisschen Wartezeit beim Antworten inklusive.
Was Quantisierung überhaupt ist
Stell dir vor, jedes Gewicht im Modell ist eine Zahl mit sehr vielen Nachkommastellen. Quantisierung bedeutet: Wir runden diese Zahlen bewusst – aber nicht wahllos, sondern so clever, dass das Modell möglichst wenig dabei verliert. Je stärker die Rundung, desto weniger Bits braucht eine Zahl und desto weniger Platz belegt sie. Veröffentlicht ist das Modell mit 16 Bit pro Zahl; wir sind bis auf 4 Bit runter.
Unser Modell ist von knapp 15 Gigabyte auf etwa 6 Gigabyte geschrumpft. Die kleinere Variante, bei der wir noch konsequenter runden, passt auf unter 5 Gigabyte. Das ist der Unterschied zwischen „braucht einen Server” und „läuft auf dem Laptop beim Frühstück” – und, siehe oben, auf modernen Chips zusätzlich ein ordentlicher Temposchub.
Der Haken: Runden kostet Genauigkeit. Wie viel, das hängt fast vollständig davon ab, womit man das Modell beim Runden füttert. Und genau da liegt die eigentliche Geschichte dieses Projekts.
Der Kalibrierungskorpus: die wichtigste Stellschraube
Beim Quantisieren schaut das Modell sich eine Menge Beispieltexte an und entscheidet anhand davon, welche Zahlen wichtig sind und welche man getrost grob runden darf. Diese Beispielsammlung nennen wir Kalibrierungskorpus. Er enthält Programmieraufgaben, Matheaufgaben, Wissensfragen, Anweisungen, Bilder und Sprachproben – und das Verhältnis dieser Kategorien zueinander ist die wichtigste Entscheidung im ganzen Prozess.
Angefangen haben wir ganz konventionell mit fertigen Quantisierungskorpora, wie man sie im Netz findet. Die sind in der Regel stark auf Code ausgerichtet, und genau das hat man dem Ergebnis auch angemerkt: Beim Programmieren war es richtig gut, sogar besser als das große unkomprimierte Original. In allen anderen Bereichen – Naturwissenschaften, Allgemeinwissen, Mathematik – war es dagegen deutlich schwächer.
Also haben wir zwei Dinge gleichzeitig angefasst. Zum einen haben wir unseren Benchmark-Korpus erweitert, also die Testfragen, mit denen wir messen: Statt uns auf Coding-Tests zu verlassen, haben wir Wissensbereiche, Naturwissenschaften, Mathematik und Anweisungstreue dazugenommen, damit wir überhaupt sehen, ob eine Qualität irgendwo einbricht. Zum anderen haben wir Wissens- und Wissenschaftsthemen zusätzlich in den Kalibrierungskorpus gepackt – und parallel dazu Bild- und Audio-Komponenten reaktiviert, die NVIDIA im Auslieferungszustand deaktiviert hatte.
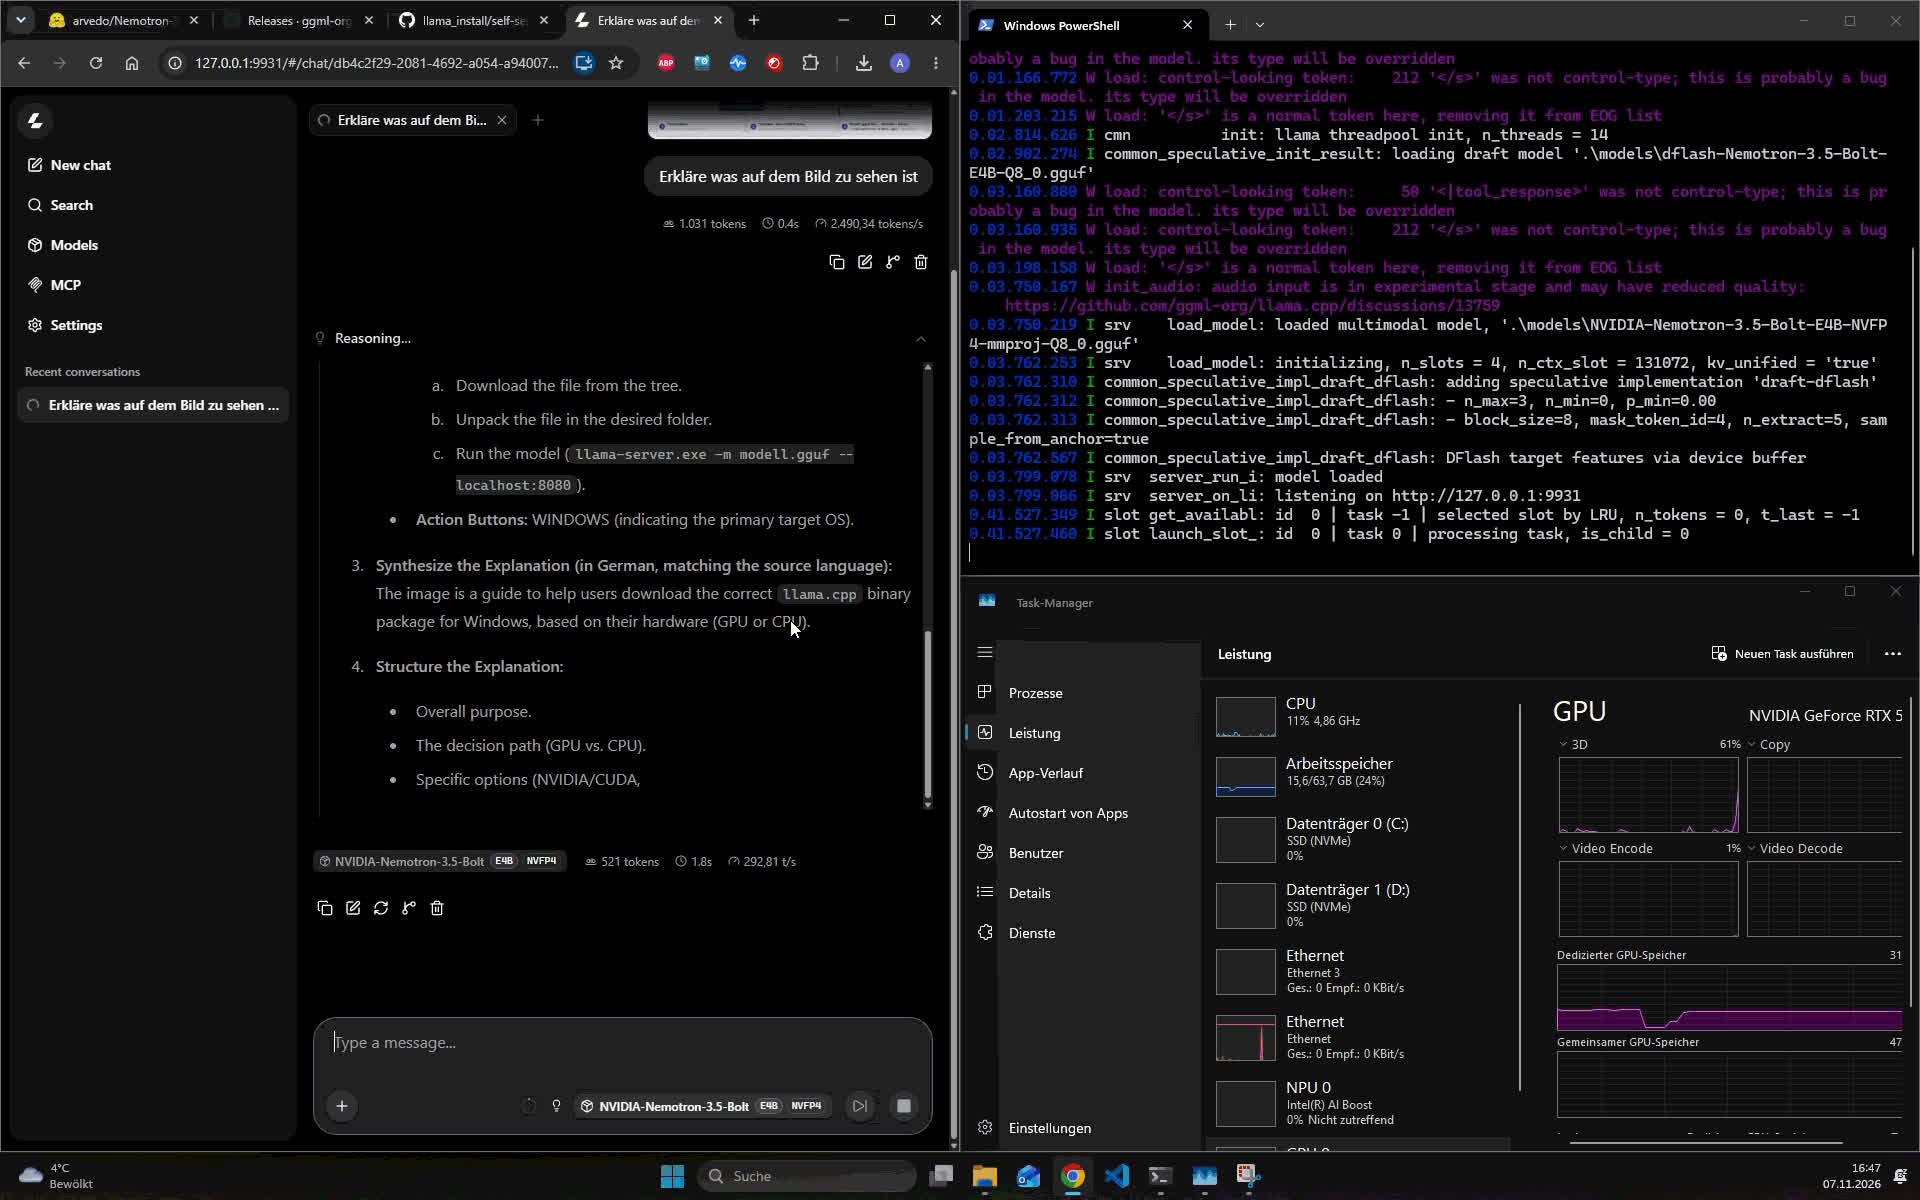
Hier ein kurzer Ausschnitt, wie das Modell Audio versteht – auch mehrsprachig:
Das hat für Bilder, Audio und Wissen auch gut funktioniert. Beim Programmieren ist uns dabei allerdings etwas entglitten – und zwar genau deshalb, weil wir nur addiert hatten. Der relative Anteil an Code war durch die neuen Themen still und leise geschrumpft. Das Modell war am Ende in fast allem gut, nur nicht mehr so richtig im Programmieren. Ausgerechnet.
Der Lauf, der alles schlechter gemacht hat
Die naheliegende Reaktion: Wir brauchen mehr Code im Korpus. Sehr viel mehr.
Wir haben den Code-Anteil drastisch erhöht, inklusive tausender echter Quelltextdateien aus bekannten Open-Source-Projekten. Ein solcher Quantisierungslauf dauert auf unserem Spark gute anderthalb Tage, also war das keine Entscheidung für zwischendurch.
Das Ergebnis war eine einzige Enttäuschung. Das Modell war in jedem einzelnen Benchmark schlechter – auch beim Programmieren. Genau dort, wo wir gewinnen wollten, haben wir verloren.
Das war der Moment, in dem wir aufgehört haben zu raten und angefangen haben, nachzuschauen. Wir haben uns angesehen, was die früheren Läufe eigentlich enthalten hatten, und die Zahlen nebeneinandergelegt. Das Muster war schnell klar: Wir waren mit einem hohen Code-Anteil gestartet, hatten ihn durch das Hinzufügen der neuen Themen unbemerkt verwässert, und hatten ihn dann viel zu weit hochgedreht. Die Mitte fehlte komplett.
Und es gab noch eine zweite Erkenntnis: Die vielen rohen Quelltextdateien waren eher schädlich als hilfreich. Unstrukturierter Code ohne Frage und Antwort bringt dem Modell nicht bei, auf eine Anfrage eine Lösung zu schreiben – er verzerrt nur die Statistik. Die Benchmarks messen aber genau den Fall „Anweisung kommt, Lösung geht raus”.
Ab hier gab es keine Vorlage mehr, die wir hätten übernehmen können. Spätestens mit Bild und Audio im Modell mussten wir unseren Korpus selbst zusammenstellen – ein fertiges Rezept für diese Mischung gab es schlicht nicht. Also haben wir ihn komplett umgebaut: ein moderater Code-Anteil, Code ausschließlich in der richtigen Frage-Antwort-Form, keine Rohdumps, keine Diff-Auszüge. Und wir haben uns einen Trick gegönnt, den wir vorher nicht auf dem Schirm hatten: Statt sofort den vollen, anderthalb Tage dauernden Lauf zu starten, haben wir erst eine abgespeckte Version gerechnet, die nur einen Bruchteil der Zeit kostet. Die reicht nicht für ein Endergebnis, aber völlig aus, um zu sehen, ob die Richtung stimmt.
Das hat sich sofort ausgezahlt. Nach wenigen Stunden wussten wir: Ja, das funktioniert. Erst danach haben wir den großen Lauf gestartet – und diesmal mit gutem Gefühl.
Am Ende stand ein Modell, das in der Gesamtsicht besser war als das offizielle GGUF von NVIDIA und dem unkomprimierten Original sehr nahe kam. Beim Programmieren liegt es weiterhin knapp dahinter – das sagen wir offen, das ist kein Schönheitsfehler, den wir aussitzen.
Was wir über das Arbeiten mit KI gelernt haben
Ein Wort dazu, wie so ein Projekt heute tatsächlich abläuft, weil es den Rahmen dessen, was man sich vielleicht vorstellt, ganz gut trifft.
Wir arbeiten bei solchen Aufgaben stark mit KI-Assistenten – beim Schreiben der Skripte, beim Auswerten von Logs, beim Zusammensetzen der Modellkarten. Und ja, die Assistenten machen Fehler. Manchmal sogar solche, bei denen man sich an die Stirn fasst: Zahlen aus einem alten Test in eine neue Tabelle übernehmen, zwei Messgrößen zu einer einzigen Zahl vermischen, oder Behauptungen über Fremdsoftware aufstellen, die schlicht nicht stimmen.
Das ist aber kein Drama und auch keine Geschichte, die wir hier ausbreiten müssen. Es ist der ganz normale Workflow: Man gibt einen Auftrag, kontrolliert das Ergebnis, korrigiert, und beim nächsten Mal sitzt es. Genau dafür ist die menschliche Review da, und genau das versuchen wir unsere Teilnehmer:innen auch zu lehren. Wer glaubt, er könne eine KI einfach machen lassen und das Ergebnis unverändert übernehmen, wird in diesem Berufsfeld schnell unglücklich.
Die eigentliche Lehre aus dem Projekt ist eine andere, und die gilt für Menschen und Maschinen gleichermaßen: Man lernt aus Fehlern, aber nur, wenn man sie sich ehrlich ansieht. Beim Quantisieren kann man sich Zahlen schönreden, die man nicht gemessen hat. Man kann Vergleiche anstellen, die unfair sind, weil die eine Variante auf der besseren Grafikkarte lief. Man kann einem Modell einen Namen geben, der eine Qualität suggeriert, die es nicht hat. Nichts davon hilft einem weiter – im Gegenteil, es verbaut einem die Diagnose.
Wir haben deshalb eine ganz simple Regel verinnerlicht: Wenn eine Zahl zu schön ist, dann wurde sie wahrscheinlich nicht gemessen. Und wenn ein Vergleich zum eigenen Modell zu gut ausgeht, dann ist meistens der Vergleich kaputt.
Wofür wir das Modell benutzen
So ein Modell ist bei uns kein Prestigeprojekt für die Schublade. In die Konzepte, an denen wir gerade arbeiten, bauen wir KI ganz selbstverständlich mit ein – und dieses Modell ist das, mit dem unsere Teilnehmer:innen später daran arbeiten.
Konkret planen wir als Übungsprojekt ein Besucherterminal: Man legt seinen Personalausweis auf, sagt, warum man zu Besuch ist und wen oder wohin man will. Das Modell liest die Daten aus dem Ausweis, versteht die gesprochene Antwort und bereitet alles so auf, dass am Ende ein Besucherausweis daraus gedruckt werden kann. Genau dafür ist es gebaut: klein, aber richtig gut im Erkennen von Bildern und Sprache.
Und jetzt kommt der Punkt, an dem die lokale Variante kein Luxus ist, sondern der eigentliche Grund: Im Personalausweis stehen besonders schützenswerte Daten. Die schickt man nicht eben an einen Cloud-Dienst. Wer so etwas bauen will, braucht eine Verarbeitung, die im Haus bleibt – und die trotzdem bezahlbar bleibt. Ein Modell, das auf einer normalen Grafikkarte läuft, macht genau das möglich.
Dazu kommt ein praktischer Nebeneffekt: Weil das Modell auf Googles Gemma-Architektur aufbaut, ist es von den gängigen Tools schon gut unterstützt. Das GGUF liegt fertig inklusive Bild- und Audio-Modul bei, und mit llama.cpp lässt es sich damit auch auf dem Mobiltelefon zum Laufen bringen. Für die Teilnehmer:innen heißt das: Das Modell steht bei uns als Endpoint bereit, aber wer in Ruhe entwickeln und debuggen will, holt es sich einfach auf den eigenen Rechner – oder aufs eigene Gerät.
Was als Nächstes kommt
Aktuell quantisieren wir gerade andere Modelle – das Projekt schläft also nicht, es hat nur mehrere Baustellen.
Aber zu diesem Modell wollen wir vermutlich noch mal zurückkommen. Der offene Punkt ist das Programmieren: Wir sind beim Code-Anteil von sehr hoch über unabsichtlich verwässert und dann viel zu hoch bei moderat gelandet. Was wir noch nicht ausprobiert haben, ist der Bereich direkt darüber – vielleicht sind 25 oder 27 Prozent der bessere Punkt als die 22 Prozent, mit denen wir aufgehört haben. Vielleicht bringt das die Coding-Werte über das offizielle GGUF, ohne den Rest kaputtzumachen. Vielleicht auch nicht, und 22 Prozent waren wirklich die Spitze des Bergs. Irgendwann testen wir das selbst.
Die Modelle liegen derweil öffentlich auf Hugging Face – zum Ausprobieren, Nachbauen und für eigene Projekte:
- Nemotron-3.5-Bolt-E4B-NVFP4-VisionAudio – die Standard-Variante
- Nemotron-3.5-Bolt-E4B-NVFP4-VisionAudio-LowMemory – die besonders kleine Variante für 8-GB-GPUs
- Nemotron-3.5-Bolt-E4B-NVFP4-VisionAudio-GGUF – für llama.cpp, inklusive Bild- und Audio-Unterstützung
Am Ende war es weniger ein Projekt über ein KI-Modell als eines über Geduld, über das richtige Messen – und über die Einsicht, dass die wichtigste Stellschraube oft nicht die ist, an der alle drehen.